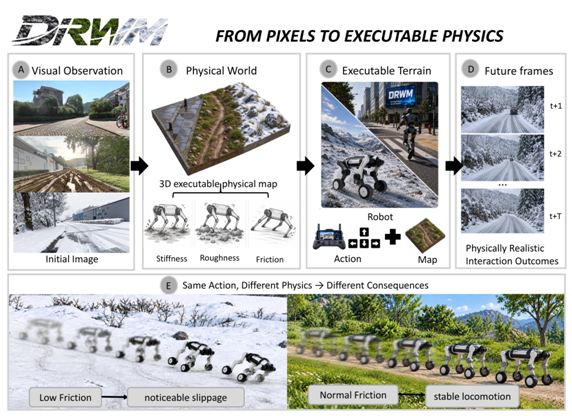
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
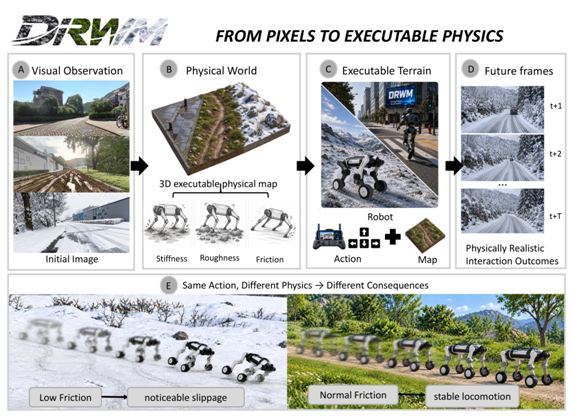
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
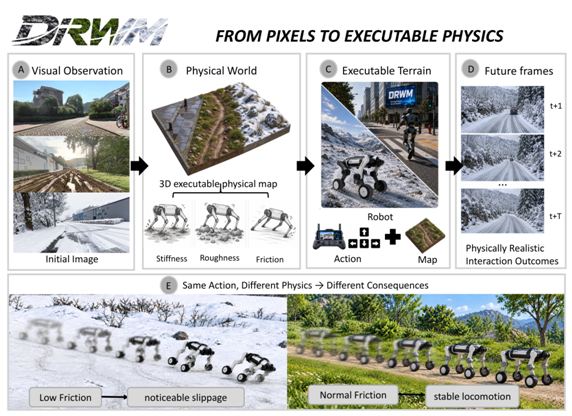
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
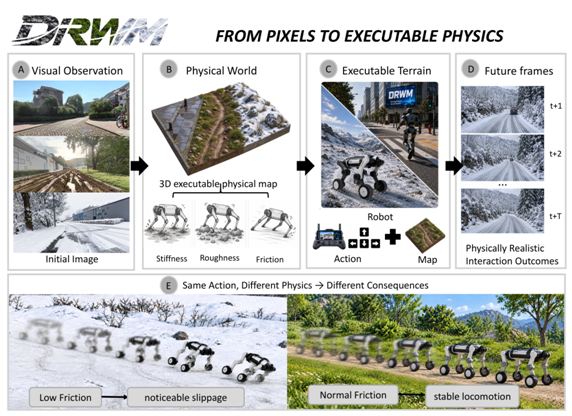
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
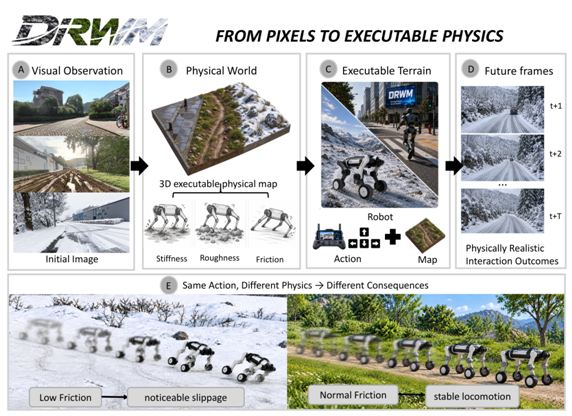
DEEP Robotics Unveils Five Research Advances in Embodied AI
Source: DEEP Robotics | GlobeNewswire Inc. New research spans world models, vision-language-action models, reinforcement learning, predictive memory and...
How Do AI Video Generators Work? From Diffusion to World Simulation
Source: Unite.AI AI video generation produces temporally connected frames from text, images, video, or control signals while attempting...